Datenleck oder nur Kaffee? Warum Ihre vernetzten Geräte Identitäts-Audits benötigen
Erfahren Sie, wie Prinzipien der Datenminimierung und gezielte Audits helfen, unüberwachte Geräte und automatisierte Datenpipelines vor Überlastung zu schützen.
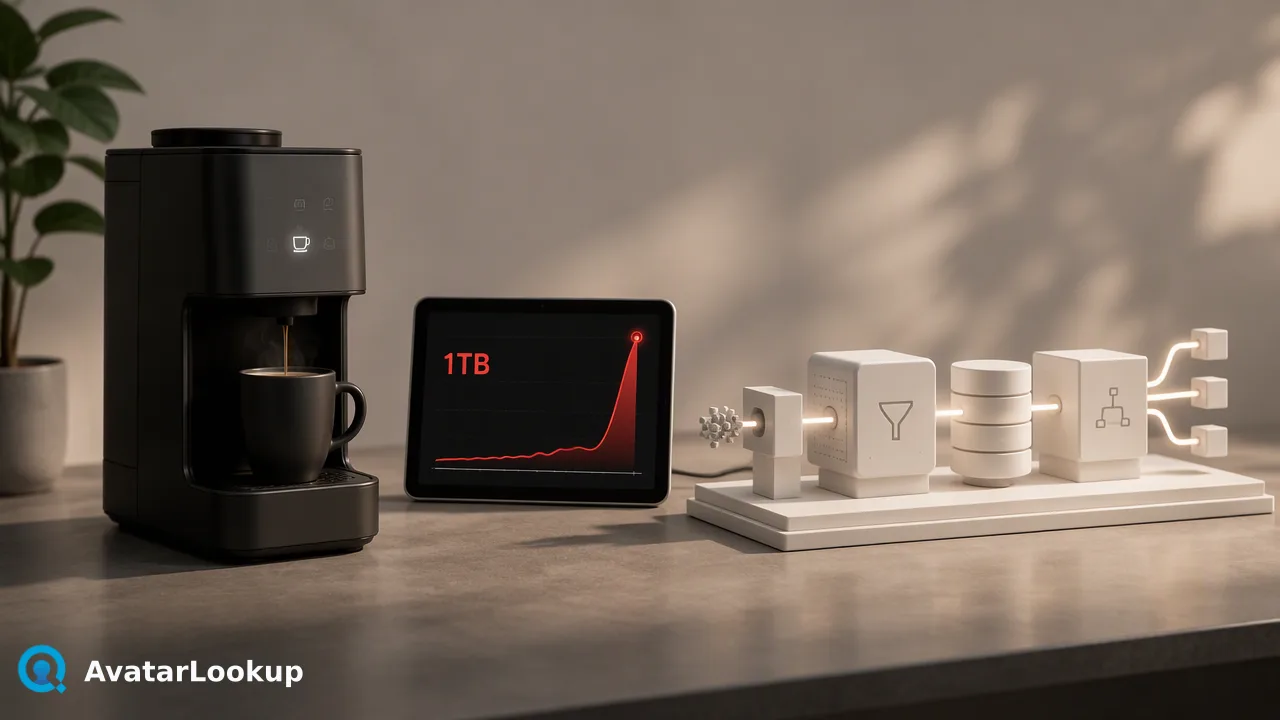
Ein viraler Vorfall, bei dem eine Kaffeemaschine 1 TB an Datenverkehr verursachte, unterstreicht die betrieblichen Gefahren unüberwachter Geräte und den Wert der Datenminimierung.
Als ein viraler Bericht enthüllte, dass eine intelligente Haushalts-Kaffeemaschine innerhalb von 10 Tagen 1 TB an Daten generierte, rückten die verborgenen betrieblichen Risiken unüberwachter vernetzter Systeme in den Fokus. In automatisierten Arbeitsabläufen können Hintergrundprozesse und Datenpipelines unbemerkt unnötige Informationen abrufen, speichern und verarbeiten. Das Prinzip der Datenminimierung – formalisiert unter GDPR Article 5 (Regulation (EU) 2016/679) – schreibt vor, dass die Datenverarbeitung angemessen, relevant und auf das unbedingt Notwendige beschränkt sein muss. Die Durchführung regelmäßiger Identitäts- und Datenaudits hilft technischen Teams dabei, Ressourcenverschwendung zu identifizieren, übermäßiges Abrufen von Daten zu vermeiden und automatisierte Abfragen auf gezielte, definierte Identifikatoren auszurichten.
Der 1-TB-Weckruf
Ein weit verbreiteter Vorfall, bei dem ein IT-Experte entdeckte, dass die smarte Kaffeemaschine seiner Eltern in 10 Tagen 1 TB an Netzwerkverkehr erzeugt hatte, bietet eine deutliche Lektion in Sachen Systemtransparenz. Während die Untersuchung ergab, dass das enorme Volumen auf einen Gerätefehler zurückzuführen war, der den lokalen Zugangspunkt überlastete, anstatt Daten über das weitere Internet zu leaken, zeigt das Szenario, wie leicht ein unüberwachtes vernetztes Gerät Ressourcen unbemerkt monopolisieren kann.
In Geschäftsumgebungen weisen automatisierte Pipelines oft das gleiche unkontrollierte Verhalten auf. Automatisierte Prozesse, wiederkehrende Datenabrufe und Hintergrund-Anreicherungsskripte können wochenlang unbemerkt ausgeführt werden. Wenn diese Prozesse ohne gezielte Abfrageparameter oder strikte Verkehrsschwellenwerte laufen, erzeugen sie betriebliche Überlastung. Unüberwachte Datenaufnahme verbraucht Netzwerkkapazität, bläht Datenbankvolumina auf und erschwert die Compliance-Situation, was die praktische Notwendigkeit regelmäßiger Audits vernetzter Endpunkte unterstreicht.
Datenüberlastung in digitalen Workflows
Der Übergang von physischen IoT-Fehlkonfigurationen zu Unternehmens-Datenpipelines ist direkt. Kontaktdatenbanken, CRM-Pipelines und automatisierte Abfrage-Warteschlangen sammeln häufig redundante Datensätze und veraltete Profilparameter. Das Abrufen nicht benötigter Attribute oder das Durchführen umfassender Anreicherungs-Scans über gesamte Kontaktlisten hinweg ohne klaren betrieblichen Bedarf verschwendet Infrastrukturressourcen und erhöht den Governance-Aufwand.
Um eine unnötige Ansammlung zu verhindern, stellen regulatorische Rahmenbedingungen strenge Anforderungen an die architektonische Zurückhaltung. Gemäß GDPR Article 5 (Regulation (EU) 2016/679) müssen personenbezogene Daten angemessen, relevant und auf das für die Zwecke der Verarbeitung notwendige Maß beschränkt sein. Die Anwendung von Prinzipien der Datenminimierung erfordert von Systemarchitekten die Bewertung jedes eingehenden Identifikators. Teams müssen feststellen, ob ein Workflow tatsächlich kontinuierliche Aktualisierungen erfordert oder lediglich eine einmalige Überprüfung der Verfügbarkeit eines öffentlichen Profils.
Strukturierung von Audits für automatisierte Datenpipelines
Die Durchführung eines Audits automatisierter Pipelines erfordert die Untersuchung, wie Hintergrundintegrationen Kontaktdaten anfordern, speichern und aktualisieren. Anstatt Integrationen unbegrenzte Abfragen ausführen zu lassen, können Unternehmen strukturierte Bewertungskriterien implementieren:
Payload-Eingrenzung: Überprüfen Sie eingehende API-Antworten, um sicherzustellen, dass interne Speicherschemata nur wesentliche Attribute erfassen, anstatt rohe, irrelevante Metadaten zu speichern.
Kadenz-Kalibrierung: Überprüfen Sie geplante Batch-Jobs, um sicherzustellen, dass automatisierte Läufe aktiven betrieblichen Workflows entsprechen und nicht veralteten, wiederkehrenden Zeitplänen.
Identifikator-Disziplin: Beschränken Sie externe Abfragen auf verifizierte Konto-Identifikatoren oder bekannte Eingaben, anstatt nicht validierte Verzeichnisse abzufragen.
Die Prüfung von Pipelines anhand dieser Standards begrenzt die passive Ansammlung und stellt sicher, dass jeder aufgenommene Datenpunkt einem aktiven, definierten Zweck dient.
Optimierung des Datenverbrauchs durch gezielte Analyse
Die Anwendung von Datenminimierung in Kontaktdaten-Workflows bedeutet, Werkzeuge auszuwählen, die für spezifische analytische Aufgaben konfiguriert sind, anstatt wahllos Daten anzureichern. Plattformen wie AvatarLookup bieten algorithmische Porträtattribute für Kontaktdaten-Workflows an, anstatt Profil- oder Identitätsverifizierungen durchzuführen, indem sie ein vorhandenes Bild oder den öffentlichen Avatar analysieren, der mit einem unterstützten Identifikator verknüpft ist.
Teams können technische Integrationen strukturieren, indem sie bei vorhandenen visuellen Assets mit der Bild-Profilanalyse beginnen, bei der Bildattribute als algorithmische Schätzungen zurückgegeben werden. Wenn nur ein Konto-Identifikator verfügbar ist, bieten Echtzeit-Einzelabfragen bei unterstützten Diensten sofortige Signale zu öffentlichen Avataren. Für größere Datensätze ermöglicht die asynchrone Massenverarbeitung per Datei-Upload geplante Überprüfungen, ohne synchrone Kanäle zu überlasten.
| Integrationstyp | Primäre betriebliche Rolle | Verarbeitungsmodell |
|---|---|---|
| Bild-Profilanalyse | Bewertet visuelle Attribute eines bereitgestellten Bildes | Synchroner Multipart-Upload |
| Identifikator-Avatar-Analyse | Prüft öffentliche Avatarsignale für spezifische Konten | Echtzeit-Einzelabfrage |
| Massen-Profilaufgaben | Verarbeitet geplante Listen über formatierte Dateien | Asynchrone Batch-Aufgabe |
Die Auswahl des präzisen Analyseumfangs hilft Unternehmen, schlanke Datenbanken zu pflegen und verschwenderisches Über-Abrufen von Daten zu verhindern.
FAQ
Was ist das Prinzip der Datenminimierung gemäß Datenschutzvorschriften?
Datenminimierung ist ein zentraler Governance-Standard, der unter GDPR Article 5 (Regulation (EU) 2016/679) festgelegt ist. Er erfordert, dass die Verarbeitung personenbezogener Daten angemessen, relevant und strikt auf das für den festgelegten betrieblichen Zweck Notwendige beschränkt ist. Die Anwendung dieses Standards stellt sicher, dass automatisierte Pipelines nur die für den Workflow wesentlichen Identifikatoren erfassen.
Wie können Unternehmen das Über-Abrufen von Daten in automatisierten Prozessen identifizieren?
Unternehmen können das Über-Abrufen von Daten aufdecken, indem sie Abfrageumfänge, Payload-Inhalte und den Hintergrund-Netzwerkverkehr prüfen. Teams sollten automatisierte Routinen überprüfen, um festzustellen, ob Aufgaben breite demografische Batches abrufen, wenn Einzelabfragen ausreichen würden, oder ob Endpunkte unnötige Profilfelder anstelle spezifischer öffentlicher Signale erfassen.
Warum sollte zwischen Einzelabfragen und Massenverarbeitung unterschieden werden?
Die Auswahl des Verarbeitungsmodus entsprechend den betrieblichen Anforderungen verhindert unnötige Datenansammlungen. Echtzeit-Einzelabfragen unterstützen sofortige, gezielte Validierungsaufgaben, während die asynchrone Massenverarbeitung geplante, groß angelegte Workflows abwickelt. Die Abstimmung des Anfrageformats auf aktuelle betriebliche Bedürfnisse unterstützt die Systemhygiene und begrenzt unnötigen Verbrauch.
Mehr erfahren
Wählen Sie die Produktinformationen, die für den nächsten Schritt in Ihrem Workflow relevant sind.