Утечка данных или просто кофе? Почему вашим подключенным устройствам нужен аудит идентификации
Узнайте, как принципы минимизации данных и целевые аудиты помогают предотвратить избыточный сбор данных неконтролируемыми устройствами и автоматизированными системами.
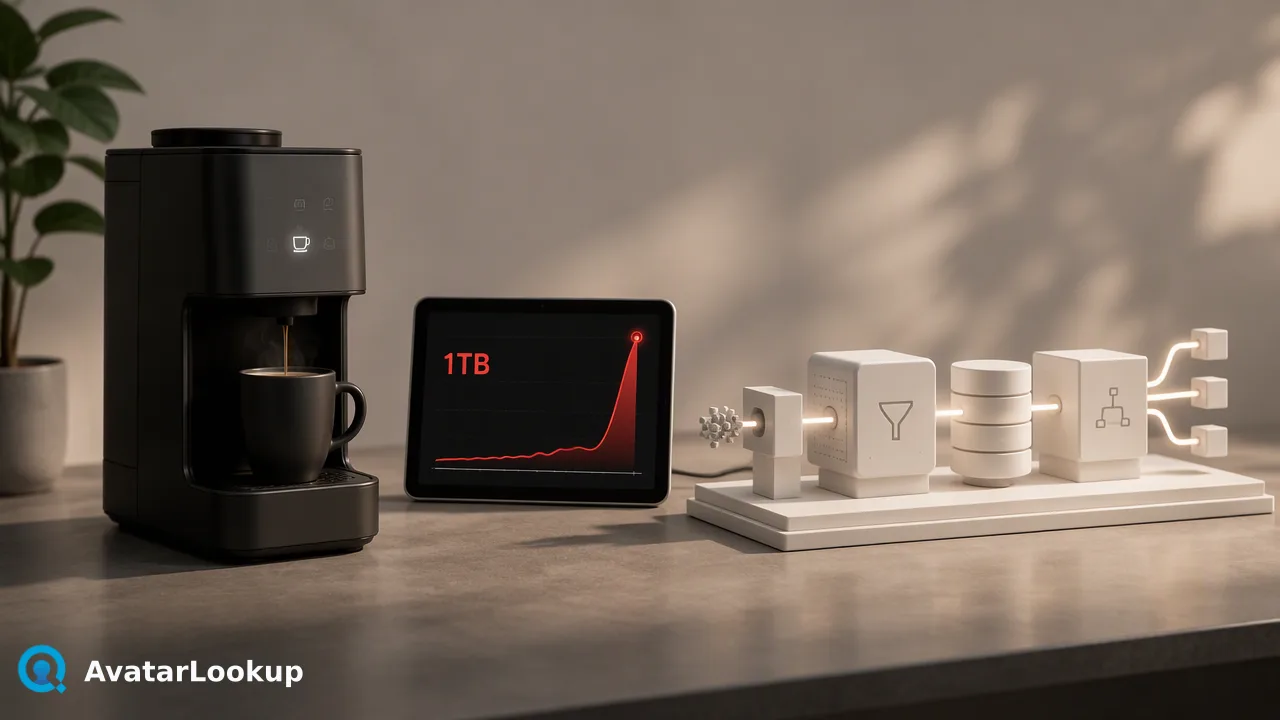
Вирусный инцидент с кофемашиной, сгенерировавшей 1 ТБ трафика, подчеркивает операционную опасность неконтролируемых устройств и ценность минимизации данных.
Когда в сети появилась информация о том, что бытовая умная кофемашина сгенерировала 1 ТБ данных за 10 дней, это высветило скрытые операционные риски неконтролируемых подключенных систем. В автоматизированных рабочих процессах фоновые процессы и потоки данных могут незаметно собирать, хранить и обрабатывать избыточную информацию. Принцип минимизации данных, закрепленный в GDPR Article 5 (Regulation (EU) 2016/679), гласит, что обработка данных должна быть адекватной, релевантной и ограничиваться только тем, что строго необходимо. Проведение регулярных аудитов идентификации и данных помогает техническим командам выявлять избыточность ресурсов, избегать чрезмерного сбора данных и структурировать автоматизированные запросы вокруг конкретных, ограниченных идентификаторов.
Тревожный сигнал объемом 1 ТБ
Широко обсуждаемый инцидент, в ходе которого ИТ-специалист обнаружил, что умная кофемашина его родителей сгенерировала 1 ТБ сетевого трафика за 10 дней, стал наглядным уроком важности видимости систем. Хотя расследование показало, что огромный объем был вызван ошибкой устройства, перегрузившей локальную точку доступа, а не утечкой через интернет, этот сценарий демонстрирует, как легко неконтролируемое подключенное устройство может незаметно монополизировать ресурсы.
В бизнес-среде автоматизированные системы часто демонстрируют такое же неконтролируемое поведение. Автоматизированные процессы, регулярные выгрузки данных и фоновые скрипты обогащения могут выполняться незамеченными неделями. Когда эти процессы работают без целевых параметров запроса или строгих порогов трафика, они создают операционную избыточность. Неконтролируемое поглощение данных потребляет пропускную способность сети, увеличивает объемы баз данных и усложняет соблюдение нормативных требований, что подтверждает практическую необходимость регулярных аудитов подключенных конечных точек.
Избыточность данных в цифровых рабочих процессах
Переход от неправильных настроек физических IoT-устройств к корпоративным потокам данных происходит напрямую. Базы контактов, CRM-системы и очереди автоматизированных проверок часто накапливают избыточные записи и устаревшие параметры профилей. Получение ненужных атрибутов или выполнение масштабного обогащения по всем спискам контактов без четкого операционного требования тратит ресурсы инфраструктуры и повышает административные расходы на управление.
Чтобы предотвратить ненужное накопление, нормативно-правовая база устанавливает строгие требования к архитектурной сдержанности. Согласно GDPR Article 5 (Regulation (EU) 2016/679), персональные данные должны быть адекватными, релевантными и ограниченными тем, что необходимо для целей их обработки. Применение принципов минимизации данных требует от системных архитекторов оценивать каждый входящий идентификатор. Команды должны определить, действительно ли рабочий процесс требует непрерывного обновления или достаточно однократной проверки доступности публичного профиля.
Структурирование аудитов для автоматизированных потоков данных
Проведение аудита автоматизированных потоков требует изучения того, как фоновые интеграции запрашивают, хранят и обновляют данные контактов. Вместо того чтобы позволять интеграциям выполнять неограниченные запросы, организации могут внедрить структурированные критерии оценки:
Определение области полезной нагрузки: Проверяйте входящие ответы API, чтобы убедиться, что схемы внутреннего хранения принимают только важные атрибуты, а не сохраняют необработанные, посторонние метаданные.
Калибровка периодичности: Проводите аудит запланированных пакетных заданий, чтобы убедиться, что автоматизированные запуски соответствуют активным операционным процессам, а не устаревшим повторяющимся расписаниям.
Дисциплина идентификаторов: Ограничьте внешние запросы проверенными идентификаторами учетных записей или известными входными данными вместо запросов к непроверенным каталогам.
Аудит потоков данных на соответствие этим стандартам ограничивает пассивное накопление, гарантируя, что каждая полученная точка данных служит активной, определенной цели.
Оптимизация потребления данных с помощью целевого анализа
Применение минимизации данных в рабочих процессах с контактными данными означает выбор инструментов, настроенных для конкретных аналитических задач, а не для неразборчивого обогащения. Такие платформы, как AvatarLookup, предоставляют алгоритмические атрибуты портрета для рабочих процессов с контактными данными, а не проверку профиля или личности, анализируя существующее изображение или публичный аватар, связанный с поддерживаемым идентификатором.
Команды могут структурировать технические интеграции, используя Анализ профиля по изображению для существующих визуальных активов, где атрибуты изображения возвращаются в виде алгоритмических оценок. Когда доступен только идентификатор учетной записи, запросы проверки в реальном времени для одного объекта в поддерживаемых сервисах предоставляют мгновенные сигналы публичного аватара. Для больших наборов данных асинхронная пакетная обработка через загрузку файлов позволяет выполнять запланированные проверки без перегрузки синхронных каналов.
| Тип интеграции | Основная операционная роль | Модель обработки |
|---|---|---|
| Анализ профиля по изображению | Оценивает визуальные атрибуты по предоставленному изображению | Синхронная multipart-загрузка |
| Анализ аватаров WhatsApp / Email | Проверяет сигналы публичного аватара для конкретных учетных записей | Проверка одного объекта в реальном времени |
| Пакетные задачи профилей | Обрабатывает запланированные списки через форматированные файлы | Асинхронная пакетная задача |
Выбор точной области анализа помогает организациям поддерживать компактность баз данных и предотвращает расточительный избыточный сбор данных.
Часто задаваемые вопросы
Что такое принцип минимизации данных согласно правилам защиты данных?
Минимизация данных — это основной стандарт управления, установленный GDPR Article 5 (Regulation (EU) 2016/679). Он требует, чтобы обработка персональных данных была адекватной, релевантной и строго ограниченной тем, что необходимо для указанной операционной цели. Применение этого стандарта гарантирует, что автоматизированные системы собирают только те идентификаторы, которые необходимы для рабочего процесса.
Как организации могут выявить избыточный сбор данных в автоматизированных процессах?
Организации могут обнаружить избыточный сбор данных путем аудита областей запросов, содержимого полезной нагрузки и фонового сетевого трафика. Командам следует пересмотреть автоматизированные процедуры, чтобы определить, выполняют ли задачи массовую выборку демографических данных, когда достаточно одиночных проверок, или же конечные точки получают ненужные поля профиля вместо конкретных публичных сигналов.
Почему стоит различать запросы для одного объекта и пакетную обработку?
Выбор режима обработки в соответствии с операционными требованиями предотвращает ненужное накопление данных. Поиск по одному идентификатору в реальном времени поддерживает немедленные, целевые задачи проверки, в то время как асинхронная пакетная обработка справляется с запланированными крупномасштабными рабочими процессами. Согласование формата запроса с текущими операционными потребностями поддерживает гигиену системы и ограничивает ненужное потребление ресурсов.
Узнать больше
Выберите информацию о продукте, которая соответствует следующему шагу в вашем рабочем процессе.