Vazamento de dados ou apenas café? Por que seus dispositivos conectados precisam de auditorias de identidade
Saiba como os princípios de minimização de dados e auditorias direcionadas ajudam a evitar que dispositivos conectados e pipelines automatizados coletem dados em excesso.
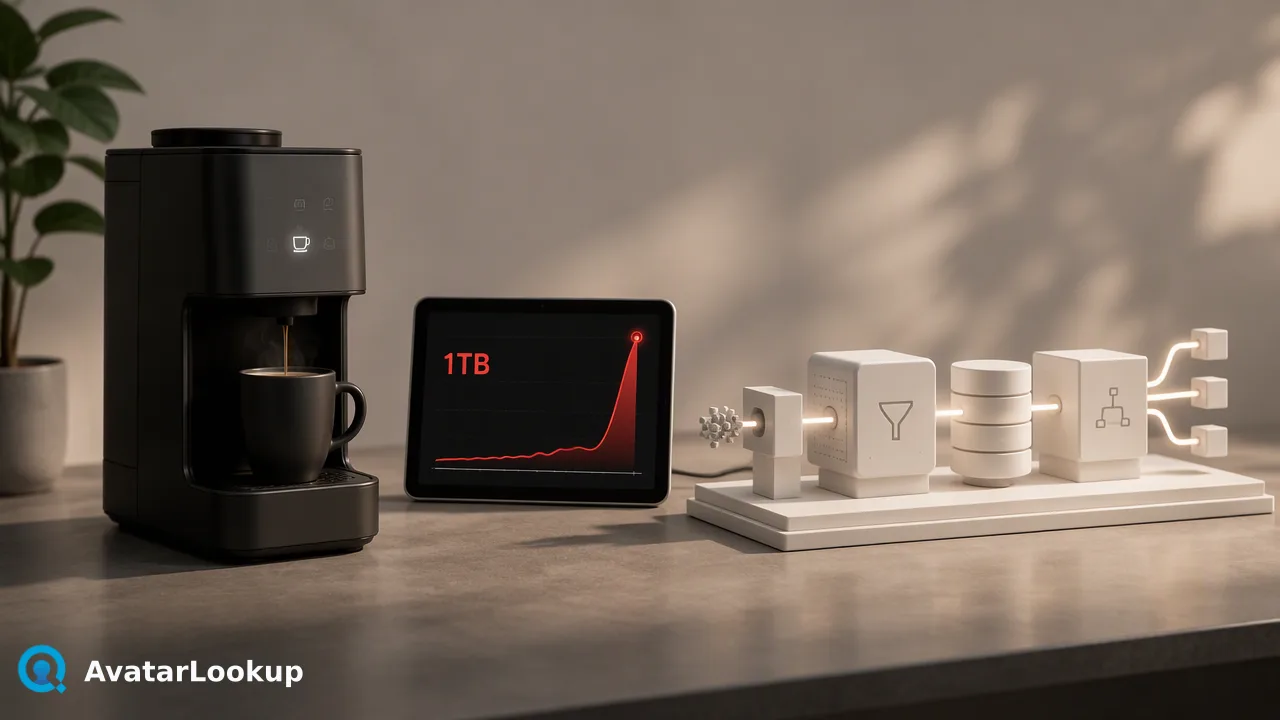
Um incidente viral de uma cafeteira gerando 1TB de tráfego destaca o perigo operacional de dispositivos não monitorados e o valor da minimização de dados.
Quando um relatório viral revelou que uma cafeteira inteligente doméstica gerou 1TB de dados em 10 dias, isso destacou os riscos operacionais ocultos de sistemas conectados não monitorados. Em fluxos de trabalho automatizados, processos em segundo plano e pipelines de dados podem silenciosamente coletar, armazenar e processar informações desnecessárias. O princípio da minimização de dados — formalizado sob o GDPR Article 5 (Regulation (EU) 2016/679) — estipula que o processamento de dados deve ser adequado, relevante e limitado ao que é estritamente necessário. Realizar auditorias rotineiras de identidade e dados ajuda as equipes técnicas a identificar o inchaço de recursos, evitar a coleta excessiva e estruturar consultas automatizadas em torno de identificadores deliberados e delimitados.
O alerta de 1TB
Um incidente amplamente divulgado, no qual um profissional de TI descobriu que a cafeteira inteligente de seus pais havia gerado 1TB de tráfego de rede em 10 dias, oferece uma lição importante sobre visibilidade de sistemas. Embora a investigação tenha indicado que o volume massivo decorreu de um erro do dispositivo saturando o ponto de acesso local, em vez de vazar dados pela internet, o cenário demonstra com que facilidade um dispositivo conectado não monitorado pode monopolizar recursos silenciosamente.
Em ambientes corporativos, pipelines automatizados frequentemente exibem o mesmo comportamento descontrolado. Processos automatizados, extrações recorrentes de dados e scripts de enriquecimento em segundo plano podem ser executados sem serem notados por semanas. Quando esses processos são executados sem parâmetros de consulta direcionados ou limites rígidos de tráfego, eles geram inchaço operacional. A ingestão não monitorada de dados consome capacidade de rede, infla volumes de banco de dados e complica as posturas de conformidade, reforçando a necessidade prática de auditorias regulares de endpoints conectados.
Inchaço de dados em fluxos de trabalho digitais
A transição de configurações incorretas de IoT física para pipelines de dados corporativos é direta. Bancos de dados de contatos, pipelines de CRM e filas de consulta automatizadas frequentemente acumulam registros redundantes e parâmetros de perfil obsoletos. Buscar atributos desnecessários ou realizar varreduras amplas de enriquecimento em listas de contatos inteiras sem um requisito operacional claro desperdiça recursos de infraestrutura e aumenta a carga de governança.
Para evitar o acúmulo desnecessário, as estruturas regulatórias estabelecem requisitos rígidos de contenção arquitetônica. Sob o GDPR Article 5 (Regulation (EU) 2016/679), os dados pessoais devem ser adequados, relevantes e limitados ao que é necessário em relação aos fins para os quais são processados. Aplicar princípios de minimização de dados exige que os arquitetos de sistemas avaliem cada identificador recebido. As equipes devem estabelecer se um fluxo de trabalho realmente requer atualizações contínuas ou apenas uma verificação única da disponibilidade de perfil público.
Estruturando auditorias para pipelines de dados automatizados
Realizar uma auditoria de pipelines automatizados exige examinar como as integrações em segundo plano solicitam, armazenam e atualizam dados de contato. Em vez de permitir que as integrações executem consultas sem limites, as organizações podem implementar critérios de avaliação estruturados:
Escopo de carga útil: Inspecione as respostas da API recebidas para garantir que os esquemas de armazenamento interno ingiram apenas atributos essenciais, em vez de salvar metadados brutos e estranhos.
Calibração de cadência: Audite trabalhos em lote agendados para verificar se as execuções automatizadas correspondem a fluxos de trabalho operacionais ativos, em vez de cronogramas recorrentes legados.
Disciplina de identificadores: Restrinja consultas externas a identificadores de conta verificados ou entradas conhecidas, em vez de consultar diretórios não validados.
Auditar pipelines em relação a esses padrões reduz o acúmulo passivo, garantindo que cada ponto de dados ingerido sirva a um propósito ativo e definido.
Otimizando o consumo de dados com análise direcionada
Aplicar a minimização de dados em fluxos de trabalho de dados de contato significa selecionar ferramentas configuradas para tarefas analíticas específicas, em vez de enriquecimento indiscriminado. Plataformas como AvatarLookup fornecem atributos de retrato algorítmicos para fluxos de trabalho de dados de contato, em vez de verificação de perfil ou identidade, analisando uma imagem existente ou o avatar público associado a um identificador suportado.
As equipes podem estruturar integrações técnicas começando com a Análise de perfil por imagem para ativos visuais existentes, onde os atributos da imagem são retornados como estimativas algorítmicas. Quando apenas um identificador de conta está disponível, consultas de verificação única em tempo real em serviços suportados fornecem sinais de avatar público imediatos. Para conjuntos de dados maiores, o processamento em lote assíncrono via upload de arquivo lida com revisões agendadas sem sobrecarregar canais síncronos.
| Tipo de integração | Função operacional principal | Modelo de processamento |
|---|---|---|
| Análise de perfil por imagem | Avalia atributos visuais de uma imagem fornecida | Upload multipart síncrono |
| Análise de foto de perfil do WhatsApp | Verifica sinais de avatar público para contas específicas | Verificação única em tempo real |
| Tarefas de perfil em lote | Processa listas planejadas via arquivos formatados | Tarefa em lote assíncrona |
Selecionar o escopo de análise preciso ajuda as organizações a manter bancos de dados enxutos e evita a coleta excessiva e desperdiçadora.
FAQ
O que é o princípio da minimização de dados sob os regulamentos de proteção de dados?
A minimização de dados é um padrão central de governança, estabelecido sob o GDPR Article 5 (Regulation (EU) 2016/679). Ele exige que o processamento de dados pessoais seja adequado, relevante e estritamente limitado ao que é necessário para o propósito operacional especificado. A aplicação deste padrão garante que os pipelines automatizados coletem apenas os identificadores essenciais para o fluxo de trabalho.
Como as organizações podem identificar a coleta excessiva em processos automatizados?
As organizações podem descobrir a coleta excessiva auditando escopos de consulta, conteúdos de carga útil e tráfego de rede em segundo plano. As equipes devem revisar rotinas automatizadas para determinar se as tarefas buscam lotes demográficos amplos quando verificações únicas são suficientes, ou se os endpoints ingerem campos de perfil desnecessários em vez de sinais públicos específicos.
Por que distinguir entre consultas de verificação única e processamento em lote?
Selecionar o modo de processamento para corresponder aos requisitos operacionais evita o acúmulo desnecessário de dados. Consultas de identificador único em tempo real suportam tarefas de validação imediatas e direcionadas, enquanto o processamento em lote assíncrono lida com fluxos de trabalho planejados e de grande escala. Alinhar o formato da solicitação com as necessidades operacionais atuais apoia a higiene do sistema e limita o consumo desnecessário.
Saiba mais
Escolha as informações do produto que se encaixam na próxima etapa do seu fluxo de trabalho.