Análisis del avatar público de WhatsApp asociado a un número
Aprenda cómo el análisis de avatares de WhatsApp evalúa señales de perfil público y estimaciones algorítmicas de retratos para números individuales y listas masivas.
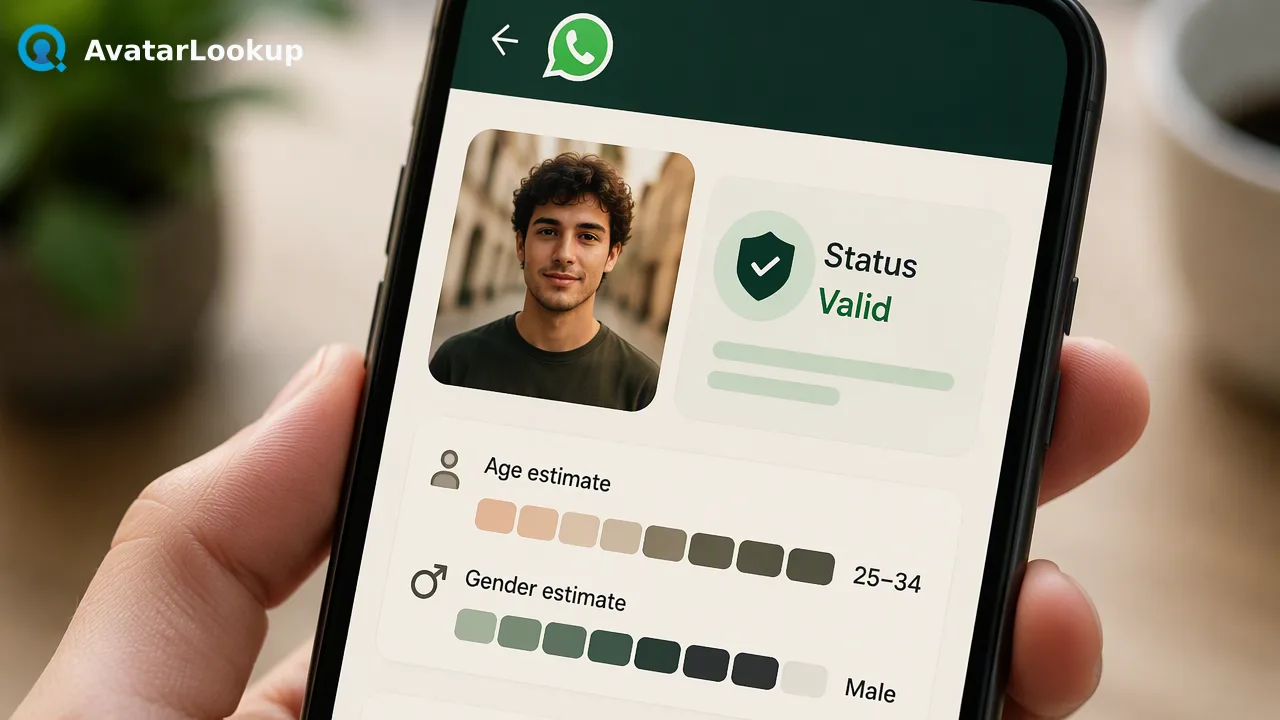
Una guía práctica para analizar avatares públicos de WhatsApp asociados a números de teléfono mediante comprobaciones individuales en tiempo real y flujos de trabajo masivos asíncronos para el enriquecimiento de datos de contacto.
El Análisis de avatares de WhatsApp evalúa señales de perfil público y estimaciones algorítmicas de retratos asociadas a un número de teléfono para enriquecer los flujos de trabajo de datos de contacto. Mientras que el Análisis de perfil de imágenes evalúa directamente una imagen cargada o una URL pública para estimar el tipo de imagen, género, edad, color de cabello y tono de piel, el Análisis de avatares de WhatsApp es la ruta a seguir cuando solo se dispone de un identificador. Las organizaciones utilizan estas señales públicas para observar el estado del perfil y las estimaciones de apariencia en el momento de la comprobación. Estos resultados sirven como señales de apoyo a la toma de decisiones automatizada, en lugar de hechos demográficos verificados o verificación de identidad, ayudando a los equipos operativos a priorizar los flujos de revisión en registros individuales o conjuntos de datos masivos asíncronos.
Análisis de avatares públicos y enriquecimiento de identificadores
AvatarLookup opera como una plataforma de análisis de avatares que examina medios visuales para asistir en los flujos de trabajo de enriquecimiento de contactos. Cuando los equipos poseen una fotografía original, el Análisis de perfil de imágenes evalúa la imagen para estimar atributos como la categoría de retrato, rango de edad, género, color de cabello y tono de piel. Sin embargo, los flujos de trabajo de contacto frecuentemente comienzan sin archivos de imagen directos. Cuando solo se dispone de un identificador, el Análisis de avatares de WhatsApp y el Análisis de avatares de email cierran esta brecha inspeccionando los datos de perfil público en el momento de la comprobación.
El proceso de análisis recupera el avatar público asociado al número de teléfono y aplica modelos algorítmicos para estimar las características del retrato. Debido a que los usuarios seleccionan sus propias imágenes de perfil público, estas señales proporcionan contexto sobre si existe una imagen de perfil y qué rasgos visuales muestra. En lugar de tratar los datos visuales como una confirmación de identidad definitiva, los equipos utilizan estas estimaciones algorítmicas junto con otros registros para informar la priorización, el enrutamiento y los flujos de trabajo de higiene de contactos.
Búsquedas individuales en tiempo real y múltiples síncronas
Las organizaciones que evalúan contactos individuales o pequeños lotes pueden utilizar comprobaciones individuales en tiempo real y comprobaciones múltiples síncronas. El flujo de trabajo de búsqueda individual inspecciona un número de teléfono específico, devolviendo el estado de registro junto con los atributos del avatar público y las estimaciones de imagen específicas de la fuente.
Para los flujos de trabajo que procesan grupos pequeños simultáneamente, la capacidad de comprobación múltiple síncrona acepta lotes de identificadores de un mismo tipo de servicio. En las operaciones síncronas, la plataforma devuelve una colección ordenada de resultados que contiene indicadores de estado y estimaciones algorítmicas.
Envíe el número de teléfono objetivo, formateado con los dígitos del país, al flujo de trabajo de comprobación individual.
Inspeccione la señal de presencia devuelta para observar el estado de registro de la cuenta en el momento de la comprobación.
Evalúe los atributos del retrato público, incluyendo la categoría de edad estimada, la apariencia de género y el tipo de categoría.
Incorpore la salida estructurada en las colas de revisión de contactos internas o en los flujos de trabajo de CRM para su enrutamiento.
Esta capacidad en tiempo real permite realizar revisiones operativas instantáneas sin esperar a la generación de archivos por lotes diferidos.
Flujo de trabajo de procesamiento masivo asíncrono
Al manejar bases de datos grandes, las organizaciones pasan a la tercera capa: el procesamiento masivo asíncrono. El flujo de trabajo masivo procesa listas de teléfonos empaquetadas en formato TXT o CSV con un identificador por línea. Se aplican límites por producto a los envíos de archivos, y los equipos deben consultar la documentación de la API actual para conocer los límites aplicables.
El flujo de trabajo masivo sigue tres fases diferenciadas:
Envío de archivos: El cliente envía un archivo de identificadores con código de país a través de
POST /api/v1/bulk-tasks, configurando los parámetros de país requeridos.Consulta de estado: La plataforma devuelve un identificador de tarea único. El cliente consulta
GET /api/v1/bulk-tasks/{id}periódicamente para verificar la finalización de la tarea, espaciando las solicitudes de estado de manera adecuada.Recuperación de datos: Una vez finalizado el procesamiento, el estado de la tarea proporciona un enlace de descarga para una exportación CSV consolidada que contiene el identificador, el estado de activación, la URL del avatar, la categoría, la edad, el género, el tono de piel y el color de cabello.
Los enlaces de descarga permanecen activos temporalmente y pueden actualizarse consultando el ID de la tarea original, lo que garantiza la resiliencia de los flujos de datos posteriores.
Interpretación de atributos devueltos y señales operativas
La interpretación de los resultados del análisis de avatares requiere comprender la distinción entre la estimación algorítmica y los registros de identidad. Los atributos devueltos (como la edad estimada, la presentación de género o las clasificaciones de color) representan evaluaciones derivadas de modelos de una imagen visual, no hechos demográficos.
Los indicadores devueltos proporcionan datos direccionales para los flujos de trabajo operativos:
Señal de registro: Confirma si la presencia de una cuenta era alcanzable en la plataforma en el momento de la comprobación.
Indicador de existencia: En las salidas de registros múltiples síncronas, exists=true denota que se produjo un resultado de análisis. Un estado exists=false indica un estado de procesamiento indeterminado, inválido o fallido, en lugar de una prueba de ausencia de cuenta.
Categoría de avatar: Diferencia entre retratos humanos, gráficos no humanos o estados de avatar vacíos. Las comprobaciones completadas que devuelven imágenes no humanas, objetos o campos de avatar vacíos representan evaluaciones determinadas.
Aplicar estas distinciones ayuda a los equipos a utilizar las señales visuales públicas de manera responsable, manteniendo al mismo tiempo una gobernanza estricta en torno a las clasificaciones automatizadas de clientes.
Preguntas frecuentes
¿Se consideran las estimaciones algorítmicas de apariencia hechos demográficos verificados?
Las estimaciones algorítmicas de apariencia reflejan evaluaciones visuales probabilísticas de una imagen de perfil pública, no hechos demográficos o legales verificados. Los avatares públicos a menudo presentan ilustraciones, fotografías de terceros o gráficos abstractos. En consecuencia, las organizaciones deben tratar atributos como la edad estimada, el género y las categorías de apariencia como señales visuales ligeras para informar las colas de revisión operativa, en lugar de utilizarlos para determinaciones de alto impacto.
¿Cómo deben interpretar las organizaciones un resultado exists=false en comprobaciones síncronas?
En las comprobaciones de múltiples identificadores síncronas, un valor exists=false indica que la solicitud produjo un resultado indeterminado, inválido o fallido durante el procesamiento. Representa el estado de la comprobación en sí, en lugar de proporcionar un veredicto negativo sobre la cuenta. Los equipos deben tratar estos registros como comprobaciones no resueltas que requieren un enrutamiento secundario, en lugar de asumir que al identificador le falta por completo un registro en la plataforma subyacente.
¿Cómo gestionan los flujos de trabajo de procesamiento masivo los requisitos y límites de las listas?
El procesamiento masivo acepta archivos TXT o CSV que contienen un identificador por línea, formateados con los dígitos del código de país. Las listas masivas se envían de forma asíncrona a través de los endpoints de tareas masivas. Debido a que los límites específicos de tamaño de archivo, los umbrales mínimos y las asignaciones de volumen máximo difieren según el servicio, se aplican límites por producto. Las organizaciones deben revisar la documentación oficial de la API para asegurarse de que sus envíos por lotes se ajusten a las especificaciones de formato y restricciones de cuota actuales.
Más información
Elija la información del producto que se ajuste al siguiente paso de su flujo de trabajo.