Guía de producto
Cómo separar los resultados disponibles, sin avatar e indeterminados
Aprenda a categorizar los resultados de análisis de avatares en flujos de datos de contacto y operaciones por lotes.
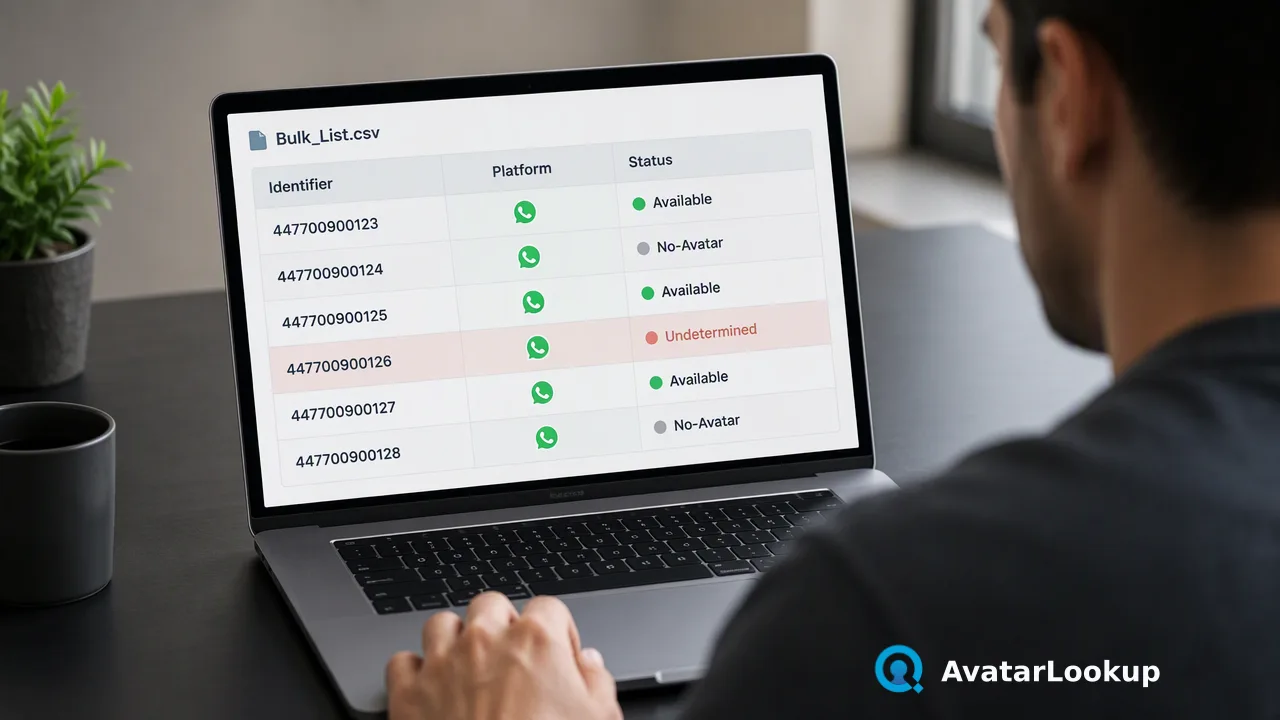
Una guía práctica de flujo de trabajo para categorizar los resultados del análisis de avatares públicos en grupos de disponibles, sin avatar e indeterminados, tanto en verificaciones individuales como en archivos por lotes.
Las categorías de resultados de verificación de avatares deben dirigirse sistemáticamente a tres grupos operativos discretos: Disponible, Sin avatar e Indeterminado. Los equipos implementan esto dirigiendo primero las entradas a través de los métodos de búsqueda adecuados (comenzando con el Análisis de perfil de imágenes o resolviendo avatares públicos a partir de identificadores de teléfono y email) y, posteriormente, categorizando la respuesta. Un estado Disponible activa el análisis algorítmico de retratos para extraer atributos de presentación auxiliares. Un estado Sin avatar registra que no se encontró ninguna imagen de perfil pública en el momento de la verificación, lo que permite que el registro de contacto continúe sin metadatos de retrato. Un estado Indeterminado dirige el registro a una cola separada para una reevaluación programada o un manejo alternativo del flujo de trabajo.
Análisis de perfil de imágenes y búsquedas basadas en identificadores
La configuración de un proceso de categorización limpio comienza con la selección del método de análisis adecuado según los datos de origen disponibles. Los equipos que manejan activos de imagen existentes deben utilizar el Análisis de perfil de imágenes directamente.
Análisis directo de imágenes
El Análisis de perfil de imágenes evalúa un archivo de imagen cargado o una URL https pública en formatos como JPEG, PNG, WEBP o GIF. Este método analiza el contenido gráfico en sí mismo sin requerir números de teléfono o direcciones de email, devolviendo atributos algorítmicos que describen el retrato visual directamente.
Análisis basado en identificadores
Cuando los equipos solo poseen un identificador de cuenta, las rutas de recuperación dedicadas resuelven los avatares públicos antes del análisis:
Análisis de avatares de WhatsApp: Recupera y evalúa avatares públicos vinculados a números de teléfono en WhatsApp.
Análisis de avatares de email: Recupera y evalúa avatares públicos para dominios de email compatibles, específicamente Gmail, Yandex y Mail.ru.
Seleccionar la ruta adecuada garantiza que las imágenes de perfil públicas se obtengan correctamente antes de que se ejecuten las reglas de categorización posteriores.
Definición de las tres categorías de resultados de verificación de avatares
Para mantener conjuntos de datos de contacto fiables, las arquitecturas operativas deben asignar cada respuesta de consulta a uno de los tres estados distintos en lugar de reducir los resultados a indicadores binarios.
| Categoría | Señal documentada | Acción recomendada del sistema |
|---|---|---|
| Disponible | Avatar público recuperado con éxito | Enviar imagen al análisis de atributos algorítmicos |
| Sin avatar | La cuenta no tiene un avatar público configurado | Registrar la presencia del identificador público sin datos de retrato |
| Indeterminado | El estado no pudo categorizarse definitivamente | Dirigir a una cola de reintento o partición de revisión neutral |
Los atributos de apariencia derivados de un resultado Disponible (como el tipo de imagen, género, edad estimada, color de cabello o tono de piel) son estimaciones algorítmicas basadas en datos de píxeles, que sirven únicamente como puntos de referencia auxiliares. Un resultado Sin avatar simplemente confirma que no se devolvió ninguna imagen pública en el momento de la verificación. Preservar la categoría Indeterminado garantiza que las búsquedas ambiguas permanezcan aisladas de los resultados confirmados.
Pasos operativos para clasificar los resultados del análisis
Las organizaciones pueden implementar un flujo de trabajo de clasificación de cuatro pasos para procesar las respuestas de búsqueda entrantes de manera fiable en todas las bases de datos de contactos.
Capturar la respuesta sin procesar: Ingerir la respuesta de verificación sin procesar desde los endpoints de identificador único o las exportaciones de finalización de archivos por lotes.
Ramificar según el estado principal: Evaluar el indicador de estado principal. Dirigir los registros Disponibles al enriquecimiento visual, los registros Sin avatar a colas de contacto solo de texto y los registros Indeterminados a una tabla de retención secundaria.
Procesar datos visuales disponibles: Para los registros con un estado Disponible, ingerir las estimaciones algorítmicas. Almacenar el tipo de imagen, los rangos de edad estimados, el color de cabello, el tono de piel y las estimaciones de género como metadatos de referencia auxiliares.
Manejar excepciones y reintentos: Mantener una clasificación neutral para las filas Indeterminadas. Programar una ejecución de seguimiento diferida o retener el registro sin etiquetas visuales, asegurando que los flujos de trabajo automatizados continúen sin interrupciones.
Pruebas de ingesta por lotes y minimización de datos
Las operaciones de datos de alto volumen utilizan el procesamiento por lotes para manejar identificadores en múltiples canales de mensajería y proveedores de email compatibles.
Formato de archivos por lotes
La ingesta por lotes admite formatos TXT y CSV que contienen un identificador por línea dentro de los límites documentados de registros por producto y tamaño de archivo, con matrices de identificadores JSON disponibles como alternativa. Las capacidades por lotes cubren servicios dedicados, incluidos Análisis de avatares de WhatsApp · Bulk, perfiles de número y nombre de usuario de Telegram, Viber, LINE, Zalo, MAX y Análisis de avatares de email · Bulk.
Gobernanza de minimización de datos
Los flujos de trabajo de procesamiento de contactos deben cumplir con los principios establecidos de gobernanza de datos. Según el Artículo 5(1)(c) del Reglamento General de Protección de Datos de la UE, los datos personales deben ser adecuados, pertinentes y limitados a lo necesario para los fines para los que se procesan (RGPD Artículo 5 (Reglamento (UE) 2016/679)). Los equipos aplican este estándar almacenando solo los atributos visuales específicos necesarios para los flujos de trabajo de contacto internos y descartando los metadatos innecesarios.
Preguntas frecuentes
¿Cómo deben procesar los sistemas un resultado de avatar indeterminado?
Un estado indeterminado indica que la plataforma no pudo resolver definitivamente el estado del avatar público durante la verificación. Los sistemas automatizados deben aislar estos registros en una cola auxiliar en lugar de tratarlos como resultados negativos. En los procesos por lotes, mantener las filas indeterminadas separadas preserva la fidelidad de la salida original y permite a los equipos programar un reintento automatizado o marcar el registro de contacto para su revisión.
¿Qué papel desempeñan los atributos de apariencia algorítmicos en los registros de contacto?
Cuando un estado de avatar se resuelve como disponible, el análisis algorítmico extrae detalles descriptivos del retrato, como el tipo de imagen, género, edad estimada, color de cabello y tono de piel. Estos atributos funcionan estrictamente como estimaciones de referencia auxiliares derivadas de los píxeles de la imagen. Los equipos los integran en los registros de contacto para proporcionar un contexto visual descriptivo durante las revisiones manuales, manteniendo la consistencia de los metadatos internos en todos los canales de comunicación compatibles.
¿Cómo se estructuran los archivos de identificadores por lotes para el procesamiento en bloque?
Los procesos por lotes requieren archivos TXT o CSV simples que contengan un identificador por línea dentro de los límites documentados de tamaño de archivo y registros por producto, o una matriz de identificadores JSON equivalente. El motor de procesamiento por lotes maneja los identificadores de mensajería y email compatibles de forma asíncrona, generando indicadores de estado de avatar claros junto con los valores de los identificadores. La lógica de enrutamiento posterior clasifica automáticamente las filas resultantes en particiones de datos disponibles, sin avatar e indeterminadas.
Más información
Elija la información del producto que se ajuste al siguiente paso de su flujo de trabajo.