Verificación de avatar: individual vs. masiva según la fuente de datos
Elija entre flujos de trabajo de verificación de avatar individual o masiva. Aprenda cuándo usar análisis de imágenes, consultas en tiempo real o lotes.
Aprenda a elegir entre el análisis de avatar individual y masivo según su fuente de datos, desde la carga directa de imágenes hasta los lotes asíncronos de plataformas de mensajería.
La elección entre una verificación de avatar individual o masiva depende de si su flujo de trabajo comienza con activos visuales o con identificadores sin procesar. AvatarLookup estructura el análisis en tres niveles claros. Cuando ya dispone de un activo de imagen, el Análisis de perfil de imágenes realiza un análisis visual directo del archivo. Cuando solo posee un identificador, WhatsApp y los dominios de email compatibles ofrecen verificaciones individuales en tiempo real o consultas síncronas de múltiples identificadores. Para grandes volúmenes en Telegram, Viber, LINE, Zalo y MAX, las tareas asíncronas de archivos masivos procesan listas de identificadores mediante exportaciones CSV por etapas. Comprender esta división específica por fuente garantiza que los equipos integren el patrón de solicitud adecuado para cada canal de datos.
Análisis de perfil de imágenes para activos visuales existentes
El Análisis de perfil de imágenes sirve como el nivel de evaluación principal cuando los equipos ya poseen un archivo gráfico o un activo visual alojado. En lugar de consultar una red de comunicaciones externa mediante un número de teléfono o nombre de usuario, este flujo de trabajo evalúa la imagen directamente. El envío se basa en la carga de archivos multipart, aceptando formatos de imagen web comunes como JPEG, PNG, WebP o GIF.
El sistema deriva una huella digital de contenido algorítmico del archivo enviado en lugar de vincularlo a un identificador de cuenta personal. La carga útil resultante proporciona atributos de retrato estructurados, incluida una clasificación de categoría de imagen junto con estimaciones algorítmicas de edad, género, color de piel y color de cabello. Los equipos utilizan este método para filtrar fotos de perfil enviadas por usuarios durante la incorporación a cuentas, auditar repositorios de fotos heredados o categorizar medios creativos entrantes. Debido a que el análisis evalúa datos visuales independientemente de la presencia en plataformas externas, opera bajo demanda para archivos multimedia individuales.
Verificaciones de identificadores en tiempo real para WhatsApp y email
Cuando solo posee un identificador en lugar de un activo de imagen, las consultas en tiempo real verifican si un avatar público es accesible en los servicios compatibles. Esta capacidad se aplica específicamente a números de teléfono de WhatsApp y dominios de webmail compatibles, cubriendo direcciones de Gmail, Yandex y Mail.ru.
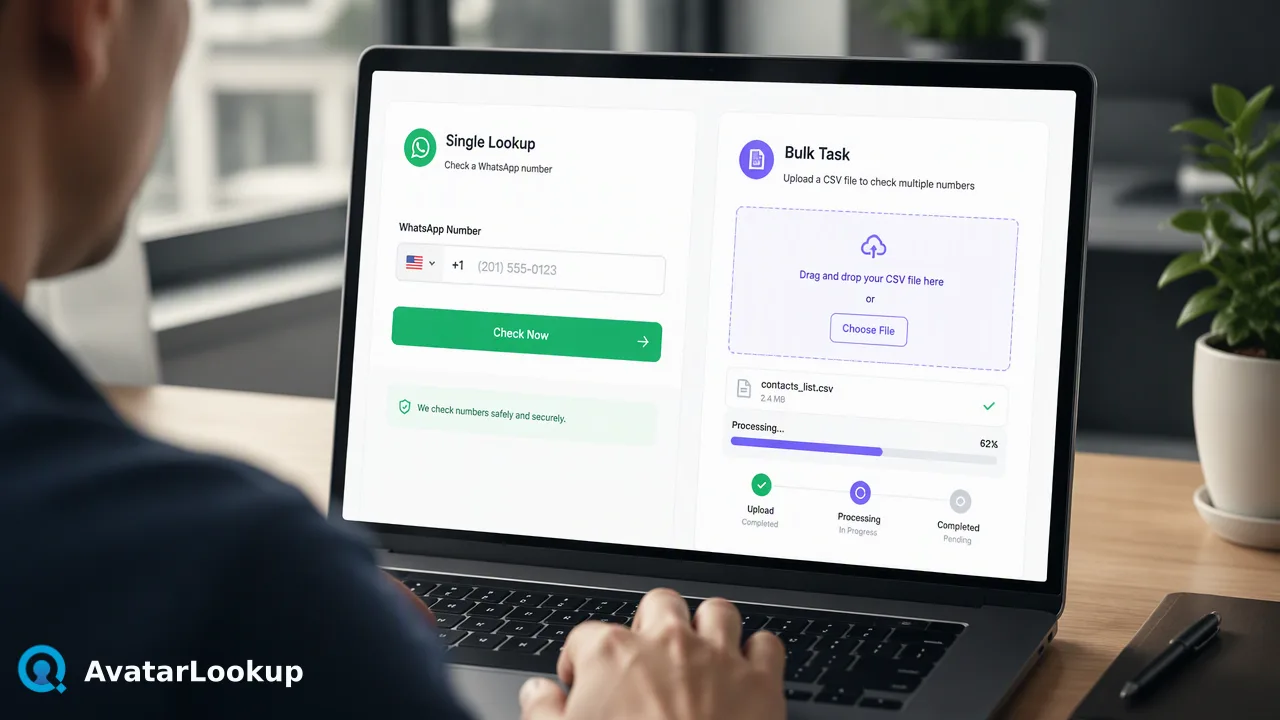
Los equipos implementan consultas síncronas utilizando POST /api/v1/check para registros individuales o POST /api/v1/batch-check para conjuntos de identificadores agrupados. El endpoint de verificación múltiple maneja lotes de 1 a 100 identificadores dentro de una sola solicitud, devolviendo una matriz JSON ordenada. Para perfiles de email, la verificación indica si la dirección puede recibir correo junto con cualquier atributo de retrato público. En las respuestas síncronas, la propiedad exists sirve como un indicador de ejecución donde true confirma que se generó un resultado, mientras que false denota una entrada no válida o un resultado indeterminado. Este patrón admite el enrutamiento de clientes potenciales en vivo, el filtrado de registros y flujos de trabajo de enriquecimiento de contactos receptivos.
Tareas asíncronas de archivos masivos para redes de mensajería
El procesamiento de datos de alto volumen a través de ecosistemas sociales más amplios cambia de llamadas en tiempo real a una ejecución asíncrona basada en archivos. Los servicios de perfil de Telegram, Viber, MAX, LINE y Zalo funcionan exclusivamente a través de tareas masivas. Las colecciones masivas de WhatsApp y email también pueden ponerse en cola mediante procesamiento masivo para manejar listas extensas sin gestionar conexiones de socket continuas.
Los flujos de trabajo masivos requieren archivos TXT o CSV simples que enumeren un identificador por fila. Los formatos de hoja de cálculo como XLSX no son compatibles. Los archivos de números de teléfono deben contener dígitos estandarizados sin espacios ni símbolos iniciales, enviados junto con un código de país ISO 3166-1. Las tareas de nombre de usuario de Telegram aceptan nombres de usuario con o sin símbolos de prefijo, omitiendo los parámetros de país regionales. Debido a que se aplican límites de archivo por producto y umbrales mínimos de identificadores, los equipos deben revisar la documentación de la API de la plataforma antes de preparar los conjuntos de entrada.
Ciclo de vida masivo de extremo a extremo e ingesta de resultados CSV
La operación de una tarea masiva asíncrona sigue un patrón de integración de tres etapas diseñado para colas de trabajos en segundo plano:
- Creación de tareas: El sistema cliente envía el archivo formateado utilizando POST /api/v1/bulk-tasks. Para servicios telefónicos, el código de país precede a la carga útil del archivo en la transmisión multipart. La plataforma devuelve un ID de tarea único.
- Estado de sondeo: El cliente monitorea el progreso del trabajo llamando a GET /api/v1/bulk-tasks/{id}. Los ciclos de sondeo automatizados no deben ocurrir con una frecuencia superior a 30 segundos para evitar una sobrecarga innecesaria de la puerta de enlace.
- Ingesta de CSV: Tras la finalización exitosa, el endpoint de estado entrega una URL de descarga de CSV segura válida por 12 horas. Actualizar la consulta de la tarea extiende los enlaces que caducan si los canales de datos experimentan retrasos en la ingesta.
Los esquemas de salida reflejan la familia de productos subyacente. Los lotes de email devuelven el identificador, el estado de activación y las rutas de imagen de avatar, mientras que los archivos de Telegram devuelven identificadores de plataforma, días de actividad y estimaciones de atributos visuales. Los ingenieros de canalización deben analizar cada archivo de producto de acuerdo con sus especificaciones de columna documentadas.
Preguntas frecuentes
¿Qué plataformas de mensajería admiten verificaciones individuales en tiempo real?
Las verificaciones individuales en tiempo real y las consultas múltiples síncronas están disponibles exclusivamente para WhatsApp y dominios de email compatibles, específicamente direcciones de Gmail, Yandex y Mail.ru. Otras plataformas de mensajería, incluidas Telegram, Viber, LINE, Zalo y MAX, operan estrictamente como flujos de trabajo de archivos masivos asíncronos en lugar de verificaciones síncronas inmediatas.
¿Qué requisitos de archivo se aplican a las tareas masivas de números de teléfono?
Las tareas masivas requieren archivos TXT o CSV formateados que contengan un identificador por línea sin formato de hoja de cálculo. Para listas basadas en teléfonos, los números requieren dígitos con código de país sin signos más ni puntuación. Los equipos envían un parámetro de país ISO 3166-1 que precede al archivo en los envíos multipart, con límites de archivo por producto detallados en la documentación oficial de la API.
¿Cómo deben interpretar los equipos una respuesta de avatar vacío o exists=false?
En las verificaciones múltiples síncronas, exists=false significa un identificador no válido, una consulta indeterminada o un endpoint no alcanzado, en lugar de una prueba definitiva de la inexistencia de la cuenta. Del mismo modo, una URL de avatar vacía o una categoría no humana refleja campos visuales determinados algorítmicamente, no una verificación de perfil o confirmación de identidad.
Más información
Elija la información del producto que se ajuste al siguiente paso de su flujo de trabajo.